国产性价比:GLM与DeepSeek直观比较
同样一段跨境文案任务,GLM 与 DeepSeek 的实际表现、速度与成本对比。
本文目录 · 8 节
大模型选型,不能只看单项跑分,也不能只看 API 单价。真正影响使用体验的,是模型在终端操作、软件工程、自动化与复杂工具调用中的综合表现,以及每次任务实际要付出的成本。
一、性能:强项不只是一项跑分
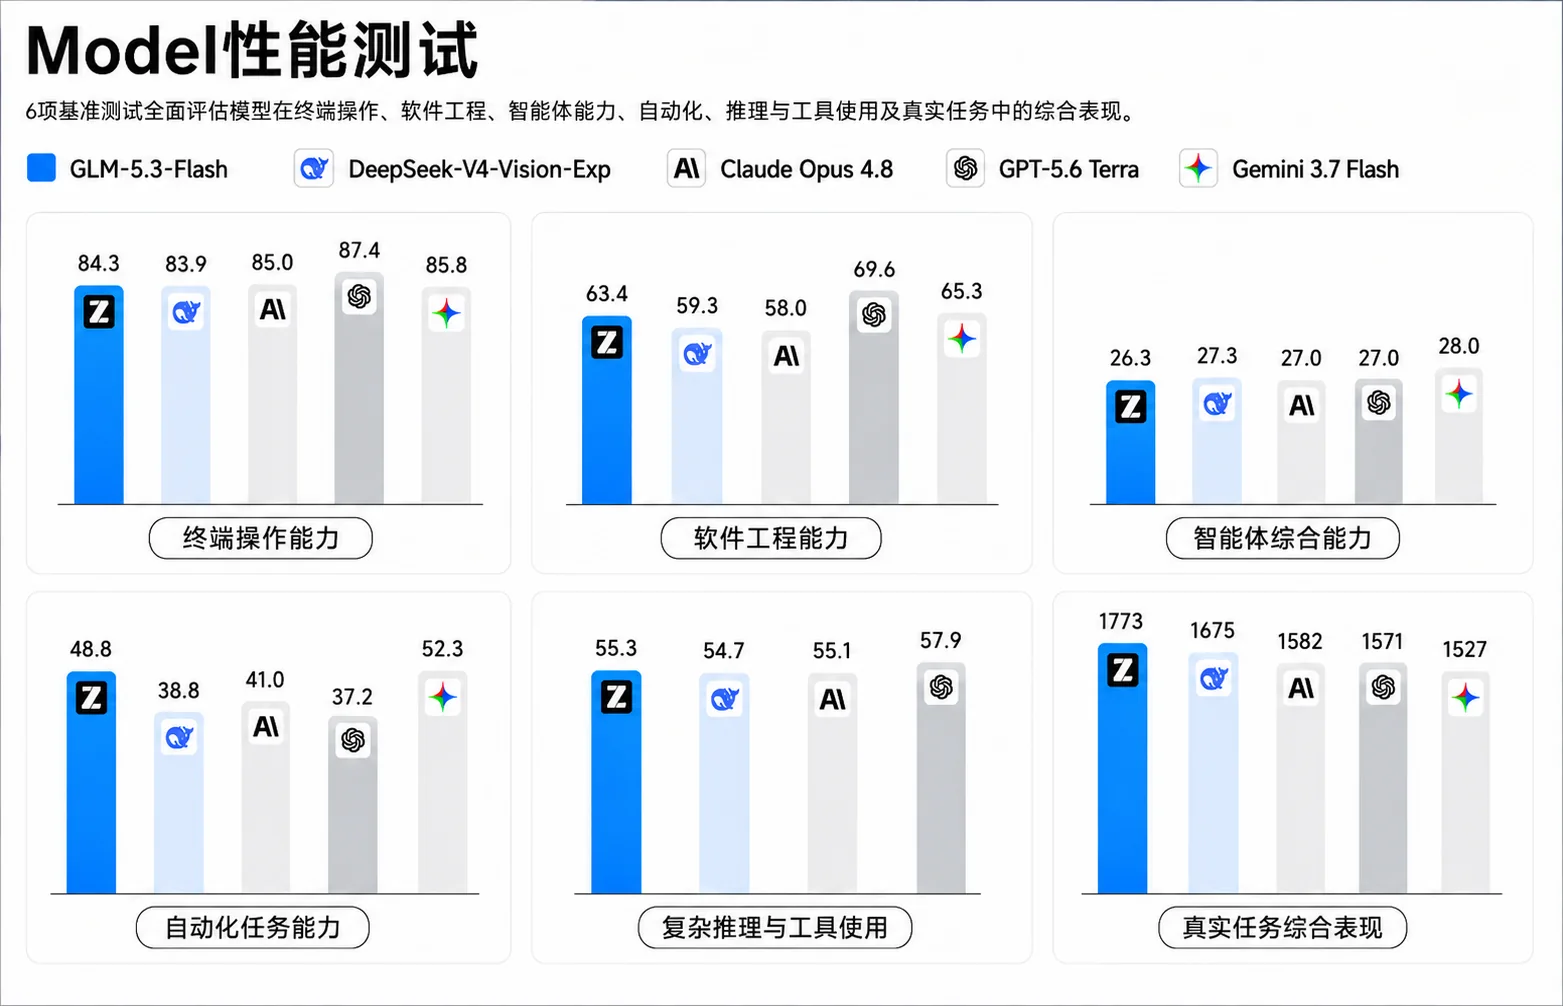
下面的测试从终端操作、软件工程、智能体综合能力、自动化任务、复杂推理与工具使用、真实任务综合表现 6 个维度,对多款模型进行了横向比较。
最值得关注的 5 个结果
- 终端操作能力:GLM-5.3-Flash 得分 84.3,与 DeepSeek-V4-Vision-Exp 的 83.9、Claude Opus 4.8 的 85.0 和 Gemini 3.7 Flash 的 85.8 处于同一梯队;GPT-5.6 Terra 以 87.4 领先。
- 软件工程能力:GLM-5.3-Flash 得分 63.4,高于图中的 DeepSeek-V4-Vision-Exp(59.3)与 Claude Opus 4.8(58.0),低于 GPT-5.6 Terra(69.6)和 Gemini 3.7 Flash(65.3)。
- 自动化任务能力:GLM-5.3-Flash 得分 48.8,仅次于 Gemini 3.7 Flash 的 52.3,并明显高于图中其余三款模型。
- 复杂推理与工具使用:GLM-5.3-Flash 得分 55.3,接近 GPT-5.6 Terra 的 57.9,也略高于 DeepSeek-V4-Vision-Exp 与 Claude Opus 4.8。
- 真实任务综合表现:GLM-5.3-Flash 的图示指标为 1773,是该组对比中的最高值。
也要看到,智能体综合能力一项的分差很小,5 款模型集中在 26.3—28.0 之间,GLM-5.3-Flash 并未领先。这意味着“某一项第一”不能直接等同于“所有 Agent 场景都最好”。
二、价格:典型调用成本更直观
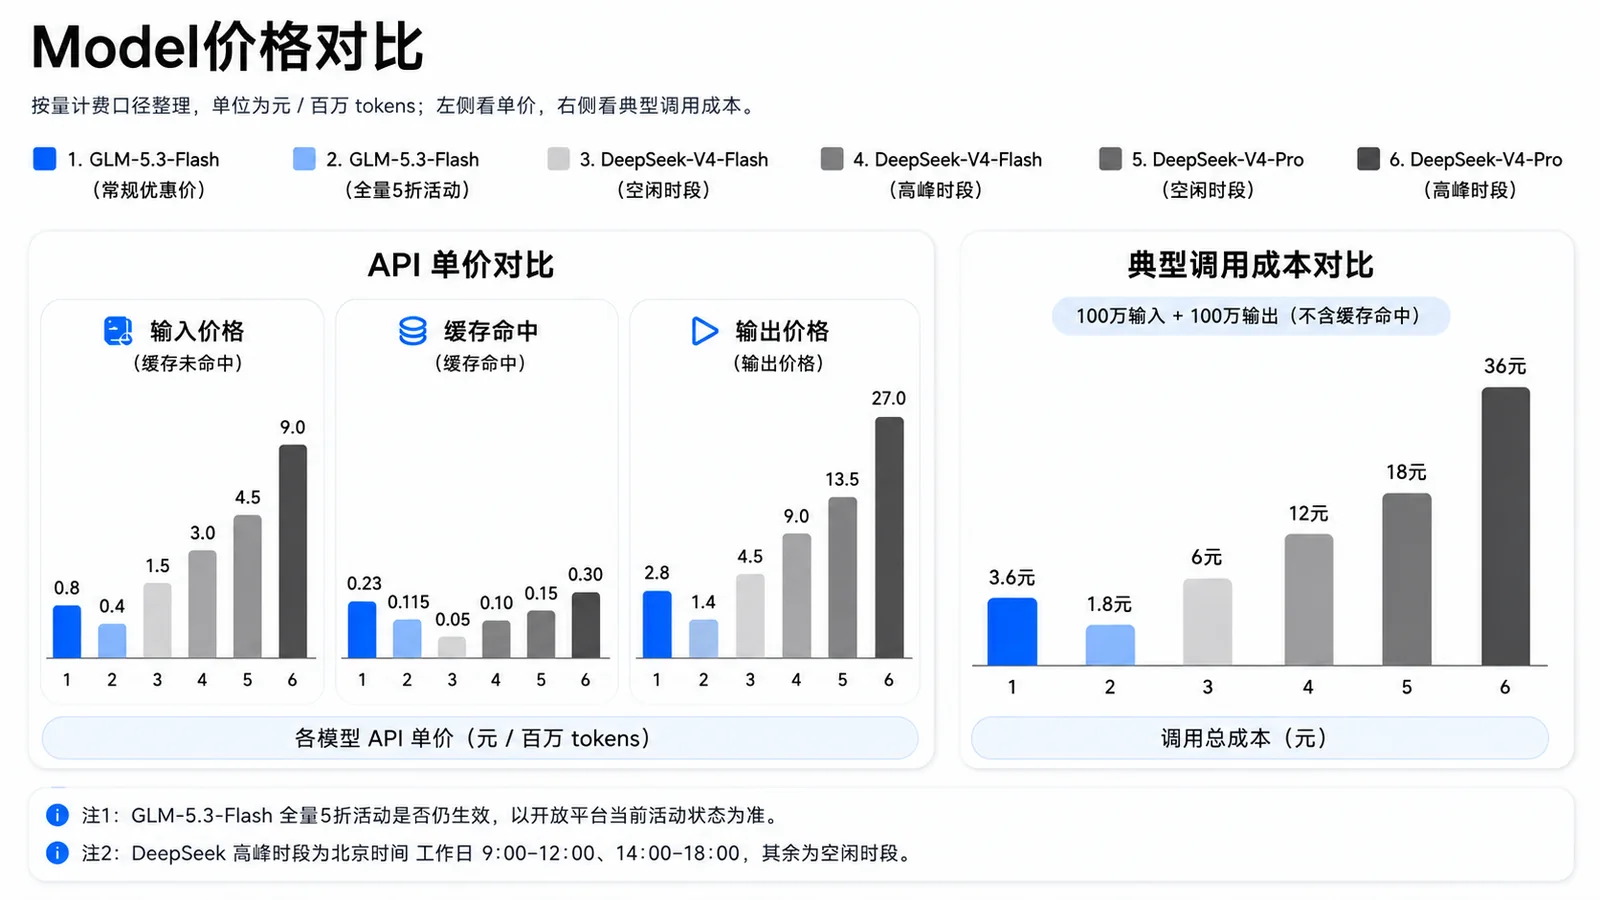
下面的价格图按“元 / 百万 tokens”整理 API 单价,并用“100 万输入 + 100 万输出、不含缓存命中”计算一次典型调用的总成本。
从单价到总成本,差距有多大?
- GLM-5.3-Flash 常规优惠价:输入 0.8 元、输出 2.8 元,典型调用合计 3.6 元。
- GLM-5.3-Flash 全量 5 折活动价:输入 0.4 元、输出 1.4 元,典型调用合计 1.8 元。
- DeepSeek-V4-Flash:空闲时段典型调用 6 元,高峰时段 12 元。
- DeepSeek-V4-Pro:空闲时段典型调用 18 元,高峰时段 36 元。
以图中价格为基准,GLM-5.3-Flash 的常规优惠价比 DeepSeek-V4-Flash 空闲时段低约 40%;若 5 折活动有效,则低约 70%。与 DeepSeek-V4-Pro 空闲时段相比,常规优惠价低约 80%。
不过,缓存命中价格并非 GLM 全面占优:图中 DeepSeek-V4-Flash 空闲时段为 0.05 元 / 百万 tokens,低于 GLM-5.3-Flash 的 0.23 元。因此,长上下文复用率很高的业务,应按真实输入、输出和缓存命中比例计算,而不是只看一组总价。
三、为什么能兼顾性能与价格?
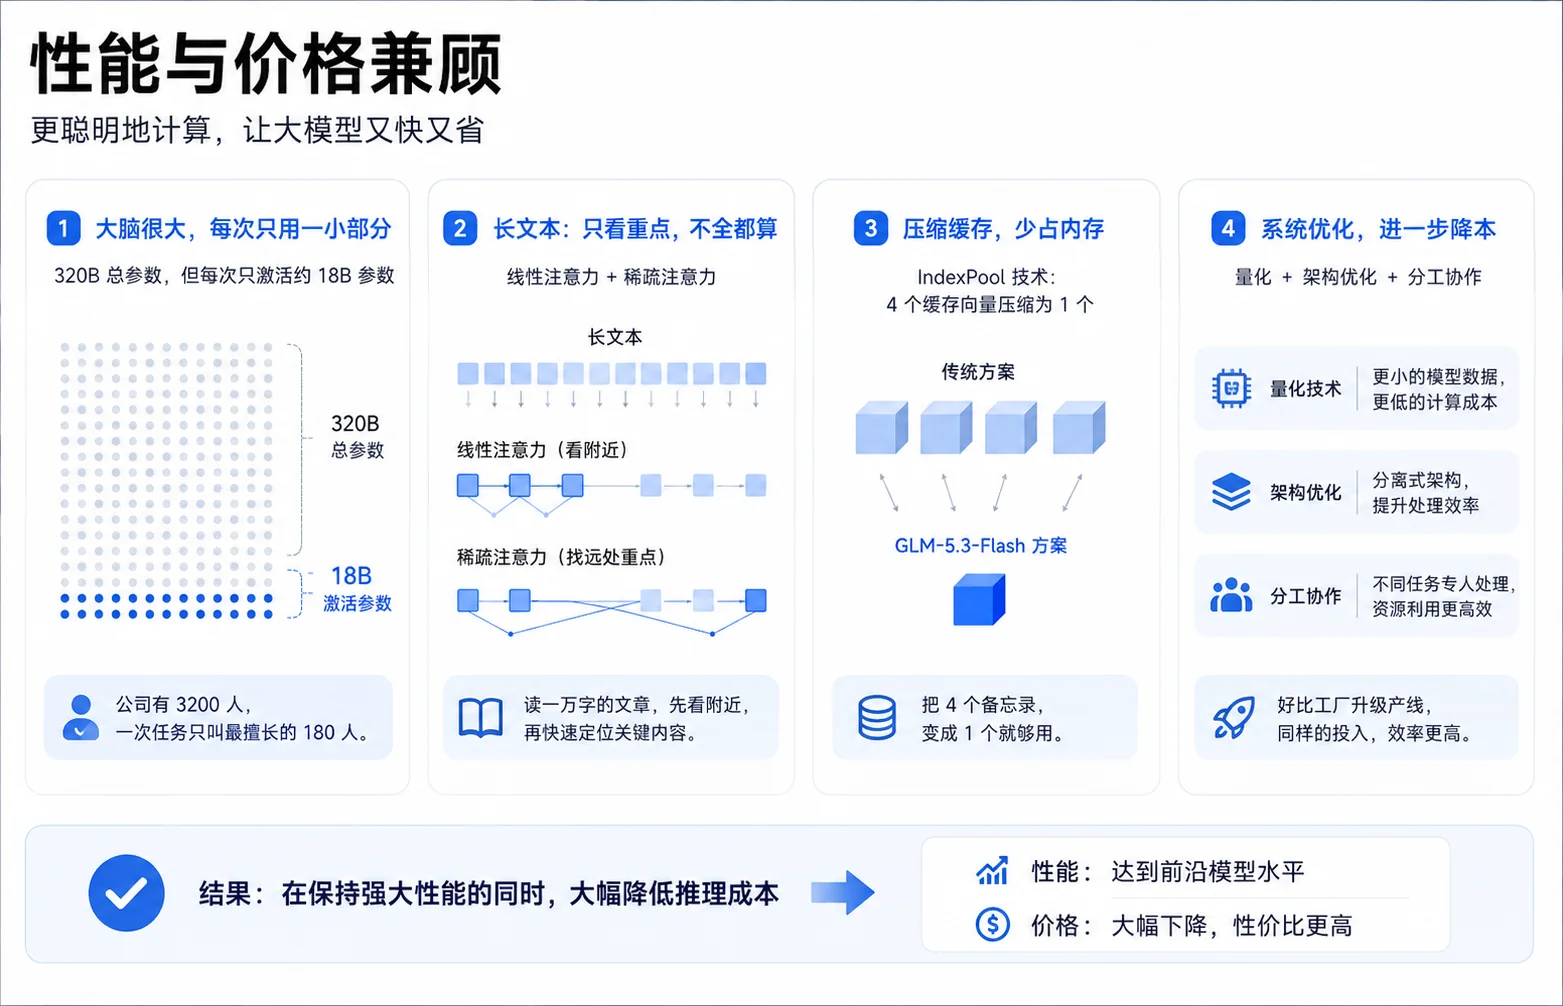
第三张图给出了 GLM-5.3-Flash 的技术解释:并不是每次推理都动用全部参数,而是通过稀疏激活、注意力优化、缓存压缩与系统工程共同降低计算成本。
四层降本逻辑
- 稀疏激活:总参数规模为 320B,但单次任务只激活约 18B 参数。图中的类比是,一家公司有 3200 人,一次任务只唤醒最擅长的 180 人。
- 长文本只抓重点:线性注意力负责快速浏览近处内容,稀疏注意力负责寻找远处关键点,减少对整段上下文的重复计算。
- 压缩缓存:IndexPool 将 4 个缓存向量压缩为 1 个,降低长上下文推理时的内存占用。
- 系统级优化:量化缩小模型数据,分离式架构提升处理效率,再通过任务分工提高资源利用率。
这些优化共同指向一个结果:在保持较强终端操作、工具调用和自动化能力的同时,把每次推理所需的计算与内存控制在更低水平,从而为更低 API 价格留出空间。
四、怎么选:先按任务,再看单价
- 高频 Agent、终端操作、流程自动化:优先实测 GLM-5.3-Flash,它在相关指标与成本上形成了较好的组合。
- 软件工程质量优先:把 GLM-5.3-Flash 与图中领先模型放入同一套代码任务中复测,重点观察一次通过率、修改正确率与重试次数。
- 长上下文且缓存命中率高:单独核算缓存成本,不能只用“输入价 + 输出价”判断总成本。
- 生产环境选型:至少同时记录成功率、平均 tokens、平均延迟、重试率和单任务总成本,再做最终决策。